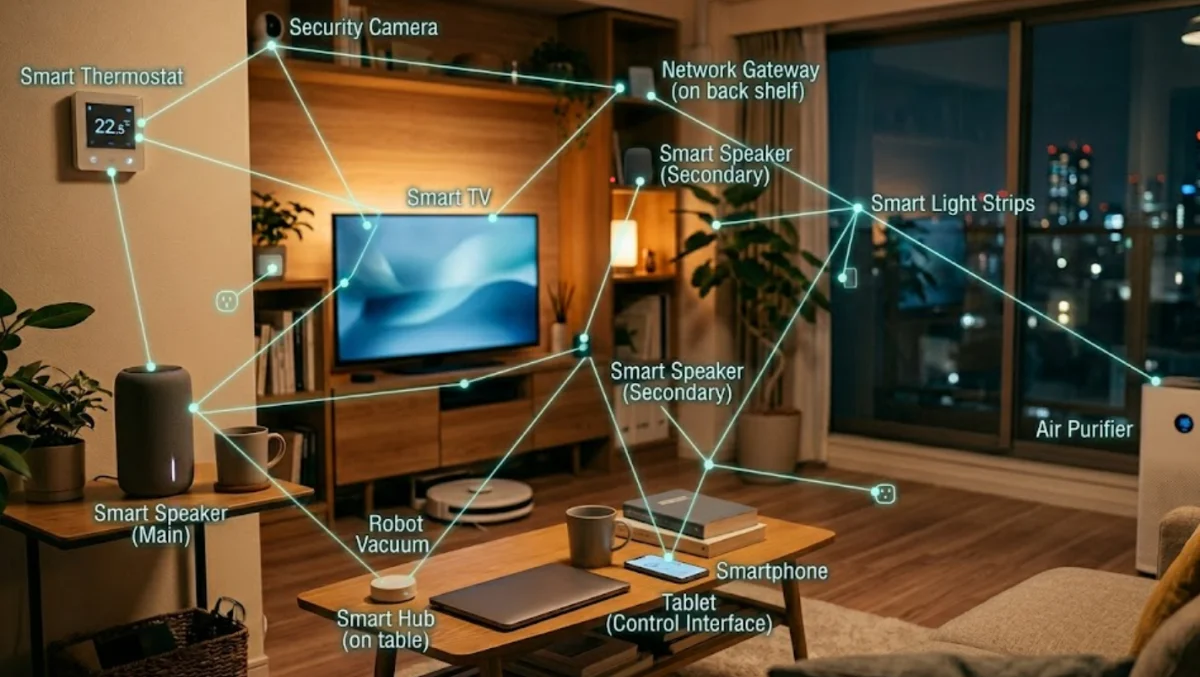
AIが自分の出力を再学習しても、現実から新しい観測値を持ち込めないことが問題の核心です。では、IoTセンサー、自動運転車、そして今まさに量産段階に入りつつあるヒューマノイドロボットが生み出す物理データはどうでしょうか。
これらは確かに現実世界から直接生まれたデータです。AI生成データとは異なり、現実の物理現象が刻まれています。直感的には枯渇問題への答えに見えますが、鍵はその物理データをどうやって言語モデルに接続するかにあります。
LLMの穴は一つではない。量とグラウンディングという2種類の欠如
AIの学習データ枯渇をデータ量だけの問題として捉えると、解像度が低くなります。現在の大規模言語モデル(LLM)が抱える根本的な弱点は、実は二種類あります。
一つ目は、データ量の枯渇です。人間がこれまでに書き残してきた高品質なテキストの量には上限があり、大規模モデルの学習はその上限に近づきつつあります。前回の記事で整理した通りの問題です。
二つ目は、グラウンディングの欠如です。グラウンディングとは、モデルが物理的な現実と接続されていることを意味します。LLMはテキストの海から言語のパターンを学びますが、重力がどのように物体に作用するか、手でコップをつかむときにどれだけの力が必要か、ロボットアームが棚の奥にある物体を取り出すときに何が障害になるかといった知識は、テキストから読み取ることができても、身体で経験しているわけではありません。
この欠如が引き起こすのがハルシネーションです。LLMが自信を持って間違いを出力するのは、データが少ないからだけではありません。物理的な現実の制約を内側から理解していないことが、根本的な原因の一つです。コーヒーを入れる手順を正確に言語化できるLLMが、実際にロボットに組み込んだとたんに的外れな動作をするのはこのためです。
物理データはこの二つの欠如に同時に作用できる可能性を持っています。データ量を補いながら、同時にグラウンディングを与える。これが、IoT・車・ロボットのデータが注目される本質的な理由です。
三種のデータには質の差がある。LLMへの貢献度で並べる
物理データとひとくちに言っても、IoTセンサー、自動運転車、ヒューマノイドが生み出すデータの質は根本的に異なります。LLMへの貢献度という軸で三段階に整理すると、構造が見えてきます。
最初の層は、IoTセンサーです。温度、振動、湿度、電流などを受動的に記録するセンサーデータは、確かに現実の観測値です。工場の設備異常検知や気候変動モデルには有効に使われています。ただし、センサーが数値を記録するだけでは、その数値が何を意味するのかという文脈がありません。37.2度という温度計の値は、人間がそれを体温計で測った患者のデータだと知って初めて意味を持ちます。意味付けがない生データは、そのままLLMの学習に投入しても言語的な文脈と結びつきません。LLMへの貢献度は三種の中で最も低い層です。
次の層は、自動運転車です。テスラをはじめとする自動運転車は、走行中にカメラ映像、LiDARによる空間情報、加速度センサー、GPS、他の車両との相対位置など、多次元の観測データを統合して記録しています。移動しながら世界を観測するという点で、受動的なIoTセンサーとは質が違います。さらに重要なのは、行動と結果の因果関係が含まれている点です。ハンドルをこの角度に切ったら、車体はこう動いた。ブレーキをこのタイミングで踏んだら、停止距離はこれだけだった。この因果データは、物理世界の動作原理をLLMに教える素材になりえます。
最上位の層は、ヒューマノイドロボットです。テスラのOptimus、Figure AIのFigure 02、Agility RoboticsのDigitなどが量産段階に入りつつある2026年現在、ヒューマノイドが生成するデータは三種の中で最もLLMへの貢献ポテンシャルが高いと考えられています。視覚、触覚、固有感覚(自分の身体の位置や姿勢の感覚)、力覚が統合されたデータが、言語による指示とセットになって記録されます。コップを棚から取り出してというタスクと、それを実行した際の手の動き・力の入れ方・失敗と修正のサイクルが一体のデータになります。これは物理的な因果関係と言語指示が直接結びついたデータです。
豆知識:テスラのデータフライホイールとは何か
テスラは世界中を走る自社車両から継続的に走行データを収集し、FSD(Full Self-Driving)の学習に使っています。従来はデータへの人手によるラベル付けが必要でしたが、テスラは独自の自動ラベリング技術を構築し、人間のアノテーションコストを大幅に削減しています。車両が増えれば増えるほど収集データが増え、モデルが改善し、車両の性能が上がり、さらに信頼できるデータが集まるという自己強化型の仕組みをデータフライホイールと呼びます。2025年から2026年にかけては、このフライホイールにGrokを統合し、車内データを言語モデルの学習にさらに直接接続する方向での開発が進んでいます。
VLAモデルという橋が、物理データをLLMに戻す
物理データがいくら豊富でも、それを言語モデルにどう届けるかという接続の問題が残ります。そしてここに、2025年から2026年にかけて急速に進展した重要な答えがあります。VLA(Vision-Language-Action)モデルという構造です。
VLAとは、視覚情報・言語指示・物理的な行動の三つを一つのモデルに統合する設計です。言語モデルのバックボーンを持ちながら、カメラ映像やセンサー入力を受け取り、ロボットの動作として出力します。これは物理データと言語モデルを直接橋渡しする仕組みです。
具体的な実装はすでに複数存在します。NVIDIAが2025年3月に発表したGR00T N1は、ヒューマノイドロボット向けの汎用基盤モデルで、22種類のロボット形態と500以上のタスクを統合したOpen X-Embodimentデータセットで学習されています。Physical Intelligenceのπゼロ(π0)は8種類の異なるロボットアームで動作を学習し、未経験のタスクへの汎化能力を持っています。Figure AIのHelixは、ヒューマノイドの上半身全体を高頻度で制御できる初のVLAとして、約500時間のロボット操作データで学習されています。
これらのモデルに共通する重要な特性があります。ロボットがタスクを実行して成功・失敗した結果は、物理的に検証可能な正解データです。コップをつかめたか、落としたか。指定した棚に物を置けたか、ずれたか。この物理的な結果が自動的にラベルになり、次の学習データとして言語モデルに還流します。
つまり物理データは言語モデルとは別のAIを生むのではなく、LLMそのものに戻ってきます。VLAという橋が存在することで、ヒューマノイドが現実世界で得た経験は、言語モデルの重みに刻み込まれていきます。
豆知識:自己教師あり学習と物理グラウンディングの違い
自己教師あり学習とは、正解ラベルを人間が付けなくても、データ自体から学習の目標を設定する手法です。テキストでは、文の一部を隠して残りから予測するマスク言語モデルがその代表例です。物理グラウンディングはこれとは異なる概念で、モデルが現実の物理的な制約や因果関係を理解していることを指します。どれだけ自己教師あり学習でテキストを大量に処理しても、物理的なグラウンディングは得られません。VLAモデルが目指しているのは、この二つを組み合わせることです。ロボットが物理世界で行動した結果を自動的に学習信号として使うことで、人手によるラベル付けを最小化しながら物理的な理解を獲得していきます。
物理データが埋める穴と、埋められない穴
物理データとVLAモデルの組み合わせを楽観的に見すぎると、別の誤解が生まれます。物理データが強化できる領域と、依然として人間の書き残しに依存する領域を正確に分けておく必要があります。
物理データが有効に作用するのは、空間推論、物理法則の理解、具体的なタスク実行、そして行動と結果の因果推論です。重いものを持つときにどれだけ腰に負担がかかるか、狭い隙間に手を入れるときにどの角度が有効か、ガラスのコップと金属の缶では同じ力のかけ方をしてはいけないことといった知識は、テキストから読み取るより物理的な経験から学ぶ方が圧倒的に効率的です。これらはまさに現在のLLMが苦手とする領域であり、ヒューマノイドデータが直接補える穴です。
一方で、物理センサーが捉えにくい領域があります。言語的なニュアンス、文化的な文脈、社会的な推論、歴史的な経緯、抽象的な概念、そして人間同士の関係性の複雑さといった領域は、カメラや力覚センサーが記録できるものではありません。これらは依然として、人間が書き残したテキストデータに依存します。
さらに、物理データにも閉じた系の制約があります。テスラの車両が集めるデータは、車が走れる環境に限定されます。ヒューマノイドが操作できるのは、ロボットが到達できる物体の範囲だけです。人間の経験の多様性、特に人が生涯にわたって積み重ねる社会的・文化的・感情的な経験の幅を、ロボットが短期間で網羅するのは設計上の制約があります。
したがって正確な評価は、物理データはLLMの穴を全部埋めるのではなく、最も重要な穴の一つ、グラウンディング欠如と物理的因果推論の弱さを埋める有望な解だということです。
物理データはデータ量と物理理解の両方をLLMに補う
IoTセンサー、自動運転車、ヒューマノイドロボットが生み出す物理観測データは、AI生成データとは根本的に異なります。AIが自分の出力を再学習するモデルコラプスの罠を回避できる、現実から直接生まれた観測値です。
そしてVLAモデルという橋の存在により、この物理データはLLMに直接還流できます。ロボットが現実世界でタスクを実行して得た因果データは、物理的な検証を経た正解データとして言語モデルの重みに積み重なっていきます。テスラのデータフライホイール、NVIDIAのGR00T N1、Physical Intelligenceのπゼロといった実装は、すでに概念段階を超えて動いています。
物理データが補えない領域は残ります。言語的なニュアンス、社会的な文脈、文化的な知識は依然として人間の書き残しに依存します。しかしそれでも、グラウンディング欠如という現在のLLMが持つ根本的な弱点と、高品質データの量的な枯渇という二つの問題に対して、物理データは同時に作用できる数少ない解の一つです。
IoTセンサーが環境を記録し、自動運転車が道路を学び、ヒューマノイドが物理的な作業を通じて世界を理解していく。この三層のデータが言語モデルに還流し続けるとき、AIの学習データ問題の地図は根本から書き換わっていきます。人間が書き残したものだけに依存してきたAIが、現実を身体で経験するデータを持つようになる。それがこの先数年で起きようとしていることの本質です。
コメント